

Matematyka w pokerze - Ocena wiarygodności statystyk
Zapraszamy do piątego artykułu z serii „Matematyka w pokerze” autorstwa PrawdziwyElBandito. W tej części zajmiemy się oceną wiarygodności statystyk. Zbadamy zależności między wielkością próbki, a szansą pomyłki w ocenie zachowań przeciwników.
Matematyka w pokerze
 |
|
Autorem tej serii jest użytkownik prawdziwyelbandito - absolwent Wydziału Matematyki Stosowanej Akademii Górniczo-Hutniczej w Krakowie, matematyk z wykształcenia, autor pracy magisterskiej z zakresu aspektów matematycznych w pokerze: "Błądzenie przypadkowe i jego zastosowanie w zarządzaniu kapitałem w pokerze".
Znajomość matematyki pozwala nam na obliczenie liczby outów, pot oddsów, wykazania opłacalności sprawdzenia lub zagrania all-in. Programy obliczeniowe pokazują nam bardzo dokładnie, jakie mielibyśmy szanse na wygranie danego rozdania, gdyby doszło do sytuacji all-in na preflopie bądź którymkolwiek późniejszym streecie. To wszystko pozwala ocenić jakość naszej gry i wprowadzić niezbędne poprawki. Matematyka pokazuje nam, jak grać i większość pokerzystów wie, że ona się nie myli, nie da się jej oszukać. W tej serii będę starał się pokazać ciekawsze oblicze zastosowań matematyki w pokerze. Zastępuję pytanie: „Jak grać w pokera?”, na rzecz pytania: „Dlaczego grać?”. Postaram się przedstawić aspekty nieco wyższej matematyki w jak najbardziej przystępny sposób.
Zmienna losowa zero-jedynkowa
W tym artykule odchodzimy od matematyki wyższej (akademickiej) i zajmiemy się zagadnieniami na poziomie matury rozszerzonej. Dziś skupimy się na najprostszym przykładzie zmiennej losowej, a mianowicie na zmiennej zero-jedynkowej. Warto w tym miejscu zwrócić uwagę, że prawie wszystkie statystyki jakie mamy w naszych HUDach opisują takie właśnie zmienne. Zmienne te przyjmują wartość 1, gdy badane zjawisko miało miejsce, i 0, gdy tak się nie stało. Na przykład gdy gracz zainwestował w pulę w preflopie, to zmienna odpowiedzialna za VPIP przyjmuje wartość 1, a gdy nie zainwestował to 0.
W naszym HUDzie natomiast obserwujemy średnią z obserwacji, która przybliża nam wartość oczekiwaną danej zmiennej. Niech teraz S (od słowa statystyka) oznacza dowolną zmienną zero-jedynkową. Jeżeli badane zjawisko zachodzi z prawdopodobieństwem p, to zmienna S je opisująca ma rozkład: S ~ {(1,p), (0,1-p)}. Jej wartość oczekiwana to:
ES = 1*p + 0*(1-p) = p, natomiast wariancja:
Var(S) = E(S2) – (ES)2 = 12 * p + 02 * (1-p) – p2 = p – p2 = p * (1 – p)
Wykres zależności Var(S) w zależności od p (czyli wartości oczekiwanej S i co za tym idzie rzeczywistej wartości badanej statystyki) jest parabolą o ramionach skierowanych do dołu i wierzchołku w punkcie (½, ¼). Oznacza to, że największa niepewność będzie nam towarzyszyć przy statystykach o wartościach rzędu 50%, a najmniejsza przy statystykach których wartości będą bliskie zeru bądź jedności. Jak widzimy zdarzają się przypadki, kiedy wariancja zależy bezpośrednio od wartości oczekiwanej danej zmiennej.
Rozkład dwumianowy
Rozważymy szereg n kolejnych obserwacji, w których możliwe były tylko dwa wyniki, z których jeden zachodzi z prawdopodobieństwem p, a drugi 1-p (możliwe do opisania za pomocą zmiennej losowej S). W pokerze byłoby to n sytuacji, w których gracz mógł wykonać daną czynność – począwszy od okazji wejścia do rozdania, przez możliwość 3betowania wobec otwarcia innej osoby, okazji do check-raise na flopie i wiele innych statystyk, które mamy w HUDach. Zastanówmy się, jaka jest szansa, że gracz wykona daną czynność dokładnie k razy (oczywiście k<=n). Sprowadza się to do zadania kombinatorycznego, na ile sposobów możemy ustawić k żółtych i (n-k) niebieskich kul w szeregu. Żółte kule symbolizują że gracz wykonał dany ruch, a niebieskie, że nie. Możemy to zrobić na:

co zilustruje przykład dla n=4 i k=2:

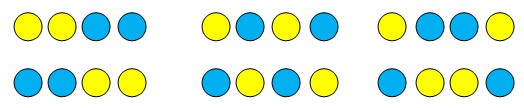
Zauważmy, że wszystkich sposobów rozłożenia n żółtych i niebieskich kul (bez ograniczenia co do ilości każdego z kolorów) mamy zawsze 2n, czyli w tym przypadku 16.
Jeżeli teraz założymy, że żółta kula znajduje się na danej pozycji z prawdopodobieństwem p, a niebieska z 1-p to prawdopodobieństwo, że w szeregu znajdzie się dokładnie k kul żółtych (gracz wykona dany ruch dokładnie k razy) wynosi:

Taki rozkład prawdopodobieństwa nazywamy rozkładem dwumianowym. Zajście danego zjawiska (kula żółta – gracz wykonał dany ruch) nazywamy sukcesem, natomiast brak zajścia badanego zjawiska (kula niebieska – gracz nie wykonał pożądanego ruchu) będziemy nazywać porażką.
Jak mierzyć wiarygodność statystyk?
Przez mierzenie wiarygodności statystyk rozumiem obliczenie prawdopodobieństwa, że zaobserwowana średnia wyników (dana statystyka z HUDa) mieści się w przedziale [p - ε, p + ε], gdzie p = ES jest wartością rzeczywistą. Musimy policzyć przy jakiej liczbie sukcesów nasza statystyka będzie mieścić się w zadanym przedziale, a później poszczególne wyniki dodać. W celu pokazania sposobu postępowania posłużymy się przykładem przytoczonym w dyskusji na forum. Zadanie wygląda więc następująco:
"Jaka jest szansa, że po 17 rozdaniach VPIP przeciwnika mieści się w granicy 80%-120% jego prawdziwego VPIP?”
Po pierwsze zauważmy, że nie tylko szerokość naszego przedziału (2ε = 40% VPIP) zależy bezpośrednio od prawdziwego VPIP, to również im VPIP jest bliższe 50% tym nasze obserwacje będzie charakteryzować większa zmienność (bo wtedy zmienna S ma największą wariancję). Dlatego koniecznym jest założenie konkretnej wartości „prawdziwego VPIP”. Obliczenia wykonamy dla VPIP = 50%. Oczywiście, to że analizujemy kwestie VPIP, a nie innej statystyki, to tylko umowa. Obliczenia będą poprawne dla każdej innej zmiennej zero-jedynkowej.
W tym przypadku mamy: ES = p = 0,5, n = 17. Przez k oznaczmy liczbę sukcesów, czyli liczbę rozdań, podczas których badany gracz zdecydował się zainwestować w pulę. Wówczas po n rozdaniach w naszym HUDzie widzimy wynik k/n. Aby on spełniał postawiony warunek musi być:

i stąd po krótkich przekształceniach: 6,8 ≤ k ≤ 10,2. Jeżeli przez kmin oznaczymy minimalne k spełniające podany warunek, a przez kmax - k maksymalne, to otrzymamy, że: kmin = 7 oraz kmax = 10. Tak więc, jeżeli nasz gracz wejdzie do rozdania 7,8,9, bądź 10 razy w naszym HUDzie pojawi się liczba spełniająca warunki zadania. Teraz należy dodać prawdopodobieństwa tych czterech zdarzeń w oparciu o wzór z rozkładu dwumianowego:
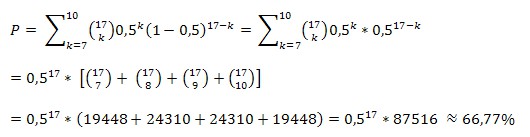
Podobnie można prowadzić obliczenia dla stałych przedziałów (np. +/- 5%) niezależnych od VPIP.
Zwróćmy jeszcze uwagę na jeden aspekt. Mianowicie jeżeli dana liczba sukcesów k spełnia warunek
to po następujących przekształceniach:
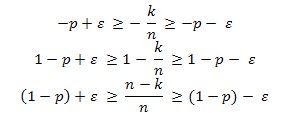
okazuje się, że liczba porażek (n-k) spełnia podobny warunek dla przedziału położonego symetrycznie względem linii 50% (dla ES = 1-p). Dodatkowo prawdopodobieństwo danej liczby porażek możemy wyznaczyć z identycznego wzoru jak dla liczby sukcesów, ponieważ

Oznacza to, że dla wartości p oraz 1-p dostaniemy te same wyniki, jeżeli chodzi o wiarygodność statystyki.
Arkusz Excela
Po raz kolejny oddaję w wasze ręce arkusz kalkulacyjny, który ułatwi wam te wszystkie obliczenia – po prostu wykona je za was. Przypominam o zmienianiu tylko żółtych komórek. Pierwszy arkusz „Wykres zależności od ES” pokazuje, jak zmienia się wiarygodność statystyki w zależności od jej wartości rzeczywistej (dla tej samej liczby rozdań i tej samej szerokości przedziału). Drugi arkusz „Wykres w zależności od n” uzależnia wiarygodność statystyki tym razem od wielkości próbki, na jakiej się opiera (stosując identyczną metodę jak przy badaniu winratu w poprzednim artykule). Pozostałe arkusze nie wymagają komentarza.
Podsumowanie
Na zakończenie chcę zwrócić uwagę, że nawet w przypadku VPIP nie można utożsamiać liczby rozdań z n, czyli liczbą sytuacji, w których była szansa, że dana akcja mogła zostać wykonana (jeżeli jesteś na BB i wszyscy spasują to nie miałeś okazji do wejścia do puli, a rozdanie jednak się odbyło). Oczywiście przy VPIP to jest bardzo bliskie, dalej mamy statystyki takie jak PFR lub Call Open, później 3bet i FoldTo3bet i kolejne, które wymagają coraz większej próbki, aż do statystyk dotyczących rivera (np. check/raise river). Na szczęście programy pokerowe oprócz wartości procentowych pokazują statystyki w formie ułamków i to są konkretne informacje – np. przeciwnik check-raisował flopa 1 raz na 10 możliwych sytuacji. To nie znaczy, że jego c/r flop to 10% ale raczej nie będzie to 30%. Wiarygodność statystyk to znów jest kwestia gustu (podobnie jak wiarygodność winratu)– jak blisko i z jaką pewnością potrzebujesz być prawdziwej wartości? Jaka zmiana powodowałaby zmianę w Twojej grze? Zwykle tak samo zagrasz na gracza z 3betem 9% jak i na tego z 8%. Dla mnie osobiście próbki wielkości kilkudziesięciu sytuacji dają już bardzo wyraźny obraz danej statystyki.
Zapraszam także do wyrażania swojej opinii na temat tej serii w wątku na forum: Forum: Matematyka w pokerze - dyskusja
Poniżej znajdziecie odnośniki do poprzednich części: Matematyka w pokerze - bilans gry jako zmienna losowa Matematyka w pokerze - wartość oczekiwana, wariancja i odchylenie standardowe Matematyka w pokerze - właściwe zrozumienie EV Matematyka w pokerze - dwie prawdy o grze w pokera
by prawdziwyelbandito
//
